
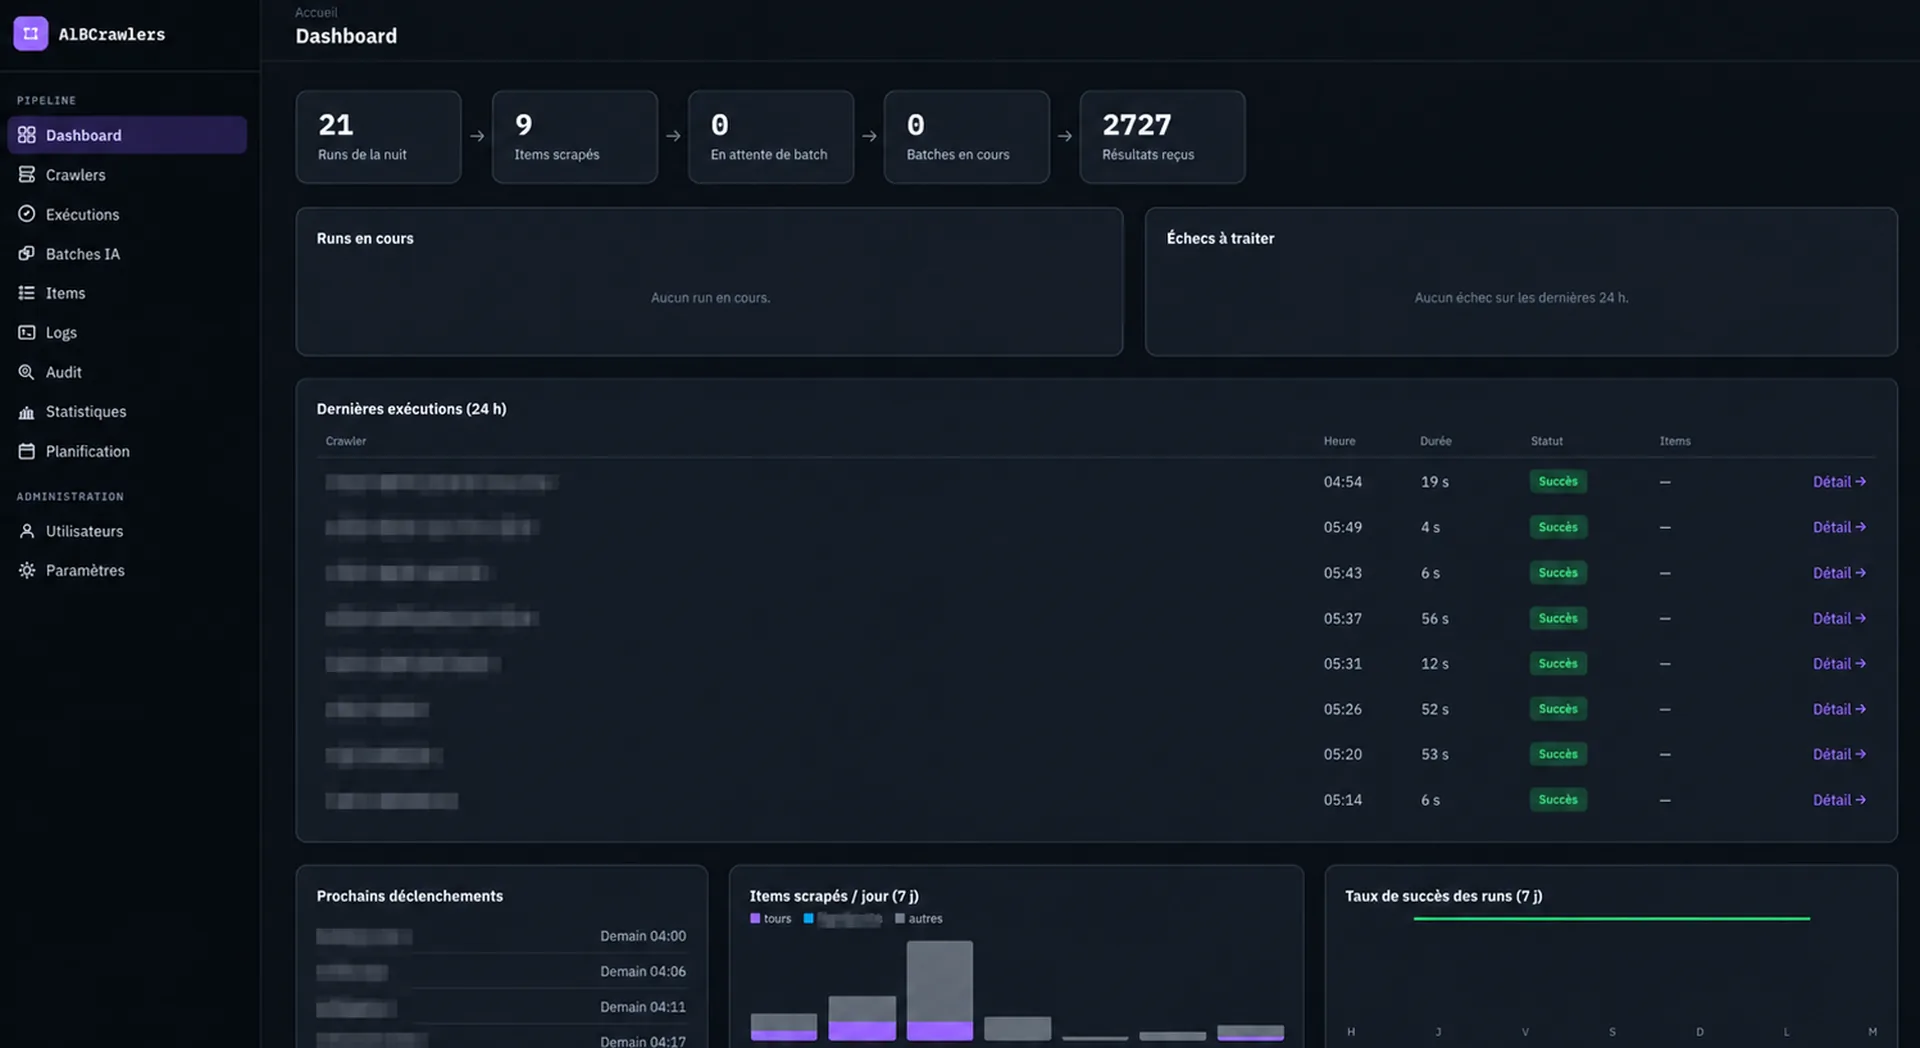
« Est-ce que tout s'est bien passé cette nuit ? »
Un robot de collecte qui fonctionne, ce n'est pas difficile à écrire. Un après-midi, un navigateur piloté par programme, quelques sélecteurs CSS, et les données arrivent. Le vrai sujet commence le jour où il y en a dix-neuf, qu'ils tournent toutes les nuits, et que quelqu'un doit pouvoir répondre à une question simple : est-ce que tout s'est bien passé cette nuit ?
Avec notre première génération de robots, la réponse demandait d'ouvrir des dossiers sur un disque et de compter des fichiers. Voici comment nous sommes passés à une plateforme qui répond seule à cette question, et ce que ça nous a appris.
Le Point de Départ : un Script par Site
La plateforme aladebauche.com (voir notre réalisation À la débauche) recense les sorties culturelles de Touraine. Elle s'alimente en allant lire les agendas que les salles de spectacle, les lieux culturels et les mairies publient déjà sur leur propre site. Un modèle de langage transforme ensuite ces pages en fiches d'événement. Cet article parle de ce qui se passe avant : aller chercher les pages, de façon fiable, tous les jours.
La première génération, démarrée en mars 2025, était un ensemble de 19 scripts indépendants, un par site, lancés à la main en ligne de commande. Chacun faisait tout lui-même :
- parcourir la liste des événements du site ;
- ouvrir chaque fiche et en extraire les champs avec des sélecteurs propres au site : « le titre est dans tel élément, la date dans tel autre » ;
- télécharger l'image ;
- écrire le résultat dans un fichier JSON, sur le disque.
Des scripts séparés envoyaient ensuite ces fichiers par lots à une API de modèle de langage, et le backoffice de la plateforme passait régulièrement lire les fichiers produits pour importer les événements.
Ça marchait. Mais tout reposait sur des conventions : un nom de dossier, un fichier présent ou absent, un script relancé au bon moment. Rien ne disait qu'un robot n'avait rien ramené depuis trois jours, ni pourquoi.
Ce qui ne tenait plus
Le code par site grossissait avec chaque site. Les 19 scripts totalisaient 5 673 lignes. Le plus long, celui d'une mairie dont le gabarit cumule les cas particuliers, en comptait 581. Chaque refonte graphique d'un site cassait ses sélecteurs, et il fallait relire le script pour comprendre lequel.
Rien n'était observable. Pas d'historique des exécutions, pas de compteurs, pas d'alerte. Une panne se découvrait par l'absence d'événements sur le site, quand quelqu'un la remarquait.
L'enchaînement était manuel. Collecter, soumettre au modèle, récupérer les résultats, importer : quatre étapes, quatre commandes, et un état qui n'existait que dans la tête de celui qui les lançait.
Séparer ce qui Change de ce qui ne Change Pas
La refonte, démarrée en juillet 2026, repose sur une idée simple : ce qui varie d'un site à l'autre, c'est la navigation, pas la lecture d'une fiche.
Trouver la liste des événements d'un site reste spécifique : une pagination classique ici, une requête AJAX qui renvoie du HTML là, un calendrier mois par mois ailleurs. Mais une fois sur la fiche d'un événement, plus besoin de savoir où se trouve le titre. Le robot capture le contenu principal de la page de façon générique, retire ce qui n'est pas du contenu (scripts, menus, bandeaux de cookies), et c'est le modèle de langage qui lit la page.
Concrètement, un module de site ne fait plus que naviguer. Tout le reste est mutualisé :
| Première génération | Seconde génération | |
|---|---|---|
| Lecture d'une fiche | sélecteurs CSS écrits pour chaque site | capture générique, lecture par l'IA |
| Code des 18 sites communs | 5 457 lignes | 2 377 lignes |
| Code commun à tous les sites | — | 980 lignes |
| Lancement | à la main, script par script | planifié chaque nuit, un site toutes les 5 à 6 minutes entre 4 h 00 et 5 h 54 |
| Suivi | fichiers sur disque | base de données et backoffice |
| Envoi vers la plateforme | fichiers lus par le backoffice | appel HTTP, rejouable sans doublon |
Sur les 18 sites communs aux deux versions, le code spécifique passe de 5 457 à 2 377 lignes : 56 % de moins. En comptant les 980 lignes de code commun, qui servent à tous les sites, le total reste inférieur de 38 %. Surtout, le site le plus complexe passe de 581 à 134 lignes : la complexité n'est plus dans la lecture des fiches, donc elle ne s'accumule plus.
Cinq nouveaux sites ont été ajoutés depuis, directement dans la nouvelle version. Elle en compte aujourd'hui 23, dont 21 actifs.
Un Événement, un État, à Chaque Instant
Le second changement est moins visible et plus important : chaque page collectée devient une ligne en base, avec un état qui dit exactement où elle en est.
- collectée
- envoyée au modèle
- en cours
- structurée
- importée
À tout moment, un événement peut aussi passer en erreur ou être écarté.
Ce cycle de vie change tout pour l'exploitation. On ne se demande plus « est-ce que ce fichier a été traité ? » : on filtre sur l'état. Une erreur ne disparaît pas, elle reste attachée à l'événement concerné, avec son message. Une page écartée l'est par une décision explicite, pas par oubli.
Le travail est découpé en files d'attente spécialisées (collecte, envoi au modèle, suivi des lots, envoi vers la plateforme, maintenance, rapport quotidien, audit), traitées par un processus de fond. Chaque étape peut échouer et être rejouée sans relancer les autres.
Une Plateforme qui Dit Elle-même ce qui ne Va Pas
C'est le gain que nous attendions le plus, et celui qu'on oublie le plus souvent de prévoir dans un projet de collecte.
Chaque exécution est tracée : début, fin, statut (succès, échec, partiel, annulé), étapes, journaux, compteurs (pages listées, pages visitées, nouveaux événements, images récupérées ou non).
Six types d'alertes sont prévus, dont quatre actifs : exécution en échec, exécution qui visite des pages sans ramener aucun événement nouveau, erreur du navigateur, erreur du modèle. Les deux autres (durée anormale, exécution manquée) existent mais restent désactivés. L'idée derrière l'alerte « zéro événement » : un site qui change de structure ne fait pas planter le robot, il le fait revenir les mains vides. Nous verrons plus bas que cette bonne idée a un coût.
L'analyse quotidienne des journaux : savoir ce qui plante, et pourquoi
Des alertes disent qu'il se passe quelque chose. Elles disent rarement quoi. Une nuit de collecte, c'est une vingtaine d'exécutions et des centaines de lignes de journal : avertissements de nouvelle tentative, codes HTTP, piles d'erreur, compteurs. Personne ne les lit chaque matin, et c'est pourtant là que se trouve l'explication.
Nous avons donc confié cette lecture à un modèle de langage. Chaque matin à 8 h, la plateforme rassemble les exécutions des dernières 24 heures, leurs compteurs, toutes les lignes d'avertissement et d'erreur, et la fin du journal de chaque exécution en échec. Le modèle rend un rapport en quatre parties, toujours les mêmes : synthèse, erreurs, avertissements, observations. Il arrive par e-mail et reste consultable dans le backoffice.
La différence avec une alerte tient en un exemple, tiré du rapport du 13 octobre 2026 :
Synthèse. La période est globalement saine : les 21 exécutions sont en succès, sans erreur bloquante. La principale anomalie concerne [un lieu de spectacle], qui a rencontré plusieurs réponses HTTP 503 et des avertissements de sélecteur sur les pages 2 à 4 de l'agenda. Ce robot n'a produit aucun nouvel événement, ce qui justifie une vérification ciblée.
Avertissements. 9 réponses HTTP 503 répétées, et 3 avertissements « Aucune fiche trouvée — sélecteur possiblement obsolète » sur les pages 2, 3 et 4. Recommandation : vérifier la disponibilité du site et le comportement du sélecteur de la liste sur ces pages, puis ajuster le sélecteur ou la stratégie de collecte si les 503 persistent.
Aucune règle d'alerte n'aurait produit ce diagnostic. Techniquement, les 21 exécutions étaient « en succès ». Le rapport, lui, relie trois signaux faibles (des erreurs serveur, un sélecteur qui ne trouve plus rien, zéro nouveauté) et en tire une conclusion et une action. Fin septembre, deux rapports consécutifs avaient de la même façon isolé la pagination bloquée d'un autre site, avec le message d'erreur exact et l'endroit du code à regarder.
Le modèle sait aussi dire ce qu'il ne peut pas conclure. Face à plusieurs robots sans nouvel événement, il écrit que « sans historique, il n'est pas possible de distinguer une absence normale de nouveauté d'un robot devenu muet ». C'est exactement la nuance qui manque à notre alerte automatique (voir plus bas).
46 rapports ont été produits depuis fin juillet. 16 signalaient des avertissements à examiner, 3 des erreurs. Les autres matins, le rapport tient en une phrase : tout va bien, et c'est aussi une information.
Cette analyse tourne sur notre propre API d'IA, ai.3gks.cloud, hébergée en France : les journaux d'exploitation ne sortent pas de notre infrastructure pour être lus.
Les Chiffres, après Trois Mois de Production
Relevés le 13 octobre 2026 dans la base de production, du 20 juillet (première exécution) au 13 octobre.
1 589
Exécutions
99,3 %
Réussies
2 763
Pages collectées
46
Rapports d'audit
| Mesure | Valeur |
|---|---|
| Nuits d'exécution planifiée | 85 |
| Exécutions réussies | 1 578 sur 1 589 |
| Exécutions en échec | 2 (et 8 partielles, 1 annulée) |
| Sur les 30 derniers jours | 610 exécutions, 608 réussies, 2 partielles, aucun échec |
| Durée moyenne d'une exécution réussie | 55 s (la plus longue : 10 min 23 s) |
| Pages d'événement collectées | 2 763, sur 22 sites |
| Pages structurées par le modèle | 2 750 |
| Événements importés | 2 725 |
| Requêtes envoyées au modèle | 3 025 dans 125 lots aboutis, 2 902 réussies (95,9 %) |
| Volume soumis au modèle | 20,2 M tokens en entrée, 3,4 M en sortie |
Une exécution nocturne qui ne ramène rien de nouveau dure quelques secondes : le robot parcourt la liste, constate que chaque fiche est déjà en base, et s'arrête. C'est ce qui permet de passer 21 sites en revue chaque nuit sans charger ni notre machine ni les sites visités.
Basculer sans Perdre de Données : le Prouver avant de le Faire
Remplacer un système qui fonctionne par un autre qui « devrait fonctionner mieux » est un pari. Nous avons préféré une preuve.
Les deux générations ont tourné en parallèle. Avant de couper l'ancienne, nous avons repris 174 événements qu'elle avait produits, sur 7 sites, et vérifié deux choses dans la nouvelle :
- présence : l'événement a-t-il été collecté ? 173 sur 174. Le seul absent correspondait à une page retirée de son site entre-temps (erreur 404) ;
- complétude : chaque information que l'ancienne version avait obtenue (titre, date, heure, lieu, ville, tarif, réservation, image) est-elle présente dans la capture de la nouvelle ?
Cette comparaison a fait remonter un vrai défaut. Sur le site d'une commune, le titre de l'événement était placé juste avant le bloc de contenu que la capture générique retient, à 430 caractères près. Résultat : 26 événements portaient comme titre le nom de la commune. Le correctif est resté générique : il ne sait rien de ce site en particulier. Il reprend le titre voisin du bloc capturé seulement s'il figure aussi dans le titre de la page. Après correction, le titre est retrouvé dans le contenu principal pour 171 événements sur 173, contre 155 avant.
Elle a aussi rappelé une évidence qu'on perd facilement de vue : les résultats de l'ancienne version n'étaient pas une vérité de référence. Neuf événements y étaient notés « gratuits » alors que la page ne mentionnait aucun tarif. Sur l'un d'eux, l'ancienne version avait retenu le logo du site comme image ; la nouvelle a trouvé la bonne affiche. Chaque écart a été vérifié sur la page source avant d'être attribué à l'une ou l'autre version.
Encart technique
- Monorepo pnpm : une application web (backoffice Nuxt), un processus de fond (worker), et quatre paquets partagés : modules de collecte, accès au modèle, base de données, types et constantes communs.
- Collecte : Crawlee et Playwright, comme en première génération. Un module de site déclare sa navigation ; la capture du contenu principal, le nettoyage du HTML et le téléchargement des images sont communs.
- Orchestration : BullMQ, 7 files de travail. Chaque site est collecté une fois par nuit, les exécutions étant étalées entre 4 h et 6 h pour ménager la machine et les sites visités.
- Base : MariaDB, 16 tables : sites, exécutions, étapes, journaux, compteurs, événements, lots, requêtes de lot, alertes, audits, historique de configuration…
- Modèle de langage : par défaut la passerelle ai.3gks.cloud, hébergée en France. La première génération envoyait ses lots à des API américaines ; le fournisseur est désormais un réglage, pas une réécriture.
- Envoi vers la plateforme : par appel HTTP authentifié, 50 événements au plus par appel. Un identifiant externe par événement rend l'envoi rejouable : un événement déjà connu est ignoré, jamais dupliqué.
- Garde-fous déterministes : un événement dont le code postal n'est pas en Indre-et-Loire est écarté avant l'envoi, quoi qu'en dise le modèle.
- Tests : 14 fichiers de tests automatisés.
Ce qui Résiste Encore
Une capture générique a ses angles morts. Pour alléger ce qui est envoyé au modèle, le nettoyage supprime les attributs techniques des balises. Or beaucoup de sites chargent leurs images en différé et ne placent la vraie adresse de l'image que dans l'un de ces attributs. La plupart du temps, l'image de partage de la page compense. Sur un site, non : sur l'échantillon de comparaison, 12 de ses 22 événements n'avaient aucune image exploitable. Le correctif est identifié (conserver les seuls attributs porteurs d'une adresse d'image), il n'est pas encore en place.
Des alertes qui ne sont jamais parties. C'est la leçon la plus inconfortable. Pendant les six premières semaines, les identifiants du serveur d'envoi d'e-mails manquaient dans la configuration de production. Le système détectait correctement ses problèmes, les enregistrait en base… et échouait à les envoyer : 633 e-mails d'alerte non remis, dont les deux seuls vrais échecs d'exécution, mi-août. Tout part normalement depuis le 2 septembre. Une alerte qui ne part pas est pire que pas d'alerte du tout, parce qu'elle donne l'illusion d'être surveillé : le canal d'alerte doit être testé comme le reste.
Une alerte trop bavarde n'est plus lue. L'alerte « zéro événement » se déclenche quand un robot visite des pages sans trouver d'événement nouveau. Sur un agenda qui n'a pas bougé depuis la veille, c'est pourtant le cas normal. Résultat sur 30 jours : 433 alertes pour 610 exécutions, soit sept sur dix. La règle doit être recalibrée, par exemple pour ne s'inquiéter qu'après plusieurs nuits consécutives sans nouveauté sur un site habituellement actif.
Un robot qui collecte une fois ne revient pas. Une page déjà en base est sautée avant toute capture. C'est voulu (on ne recharge pas tous les jours des centaines de pages déjà traitées), mais cela signifie qu'un correctif de capture ne profite pas aux événements existants : il faut les retirer de la base pour qu'ils soient collectés à nouveau.
Les sources se recoupent. L'agenda d'une grande ville republie les événements de plusieurs structures qui ont leur propre robot. Sans filtre, chaque événement arriverait deux fois. Ces filtres sont écrits source par source, et c'est l'un des rares endroits où du code spécifique reste nécessaire.
Le modèle doit être encadré, pas seulement interrogé. Une page qui écrit « 5 décembre » sans année, une limite de longueur de réponse fixée côté serveur et dépassée sans erreur, un événement hors département structuré malgré la consigne : chaque fois, la correction a été une règle mesurée ou un contrôle déterministe autour du modèle, jamais la seule confiance dans sa réponse.
Ce qu'il Faut en Retenir
Si vous faites tourner des robots de collecte, des imports de fichiers ou des synchronisations entre systèmes, la question n'est pas seulement « est-ce que ça marche ? ». C'est « comment saurai-je que ça ne marche plus ? », et « combien de code devrai-je réécrire quand une source changera ? ».
Les deux réponses tiennent dans la même démarche : isoler ce qui est vraiment spécifique à chaque source, donner à chaque donnée un état lisible, et faire en sorte que le système signale lui-même ses défaillances, en les expliquant. Des journaux que personne ne lit ne servent à rien ; un rapport quotidien qui les interprète, si. Et quand on remplace l'existant, prouver avant de basculer.
— Laurent Lefèvre
Pour Aller Plus Loin
Des données à aller chercher ?
Sites ou systèmes que vous ne maîtrisez pas, imports, synchronisations : parlons-en, c'est le cœur de ce que nous construisons.