
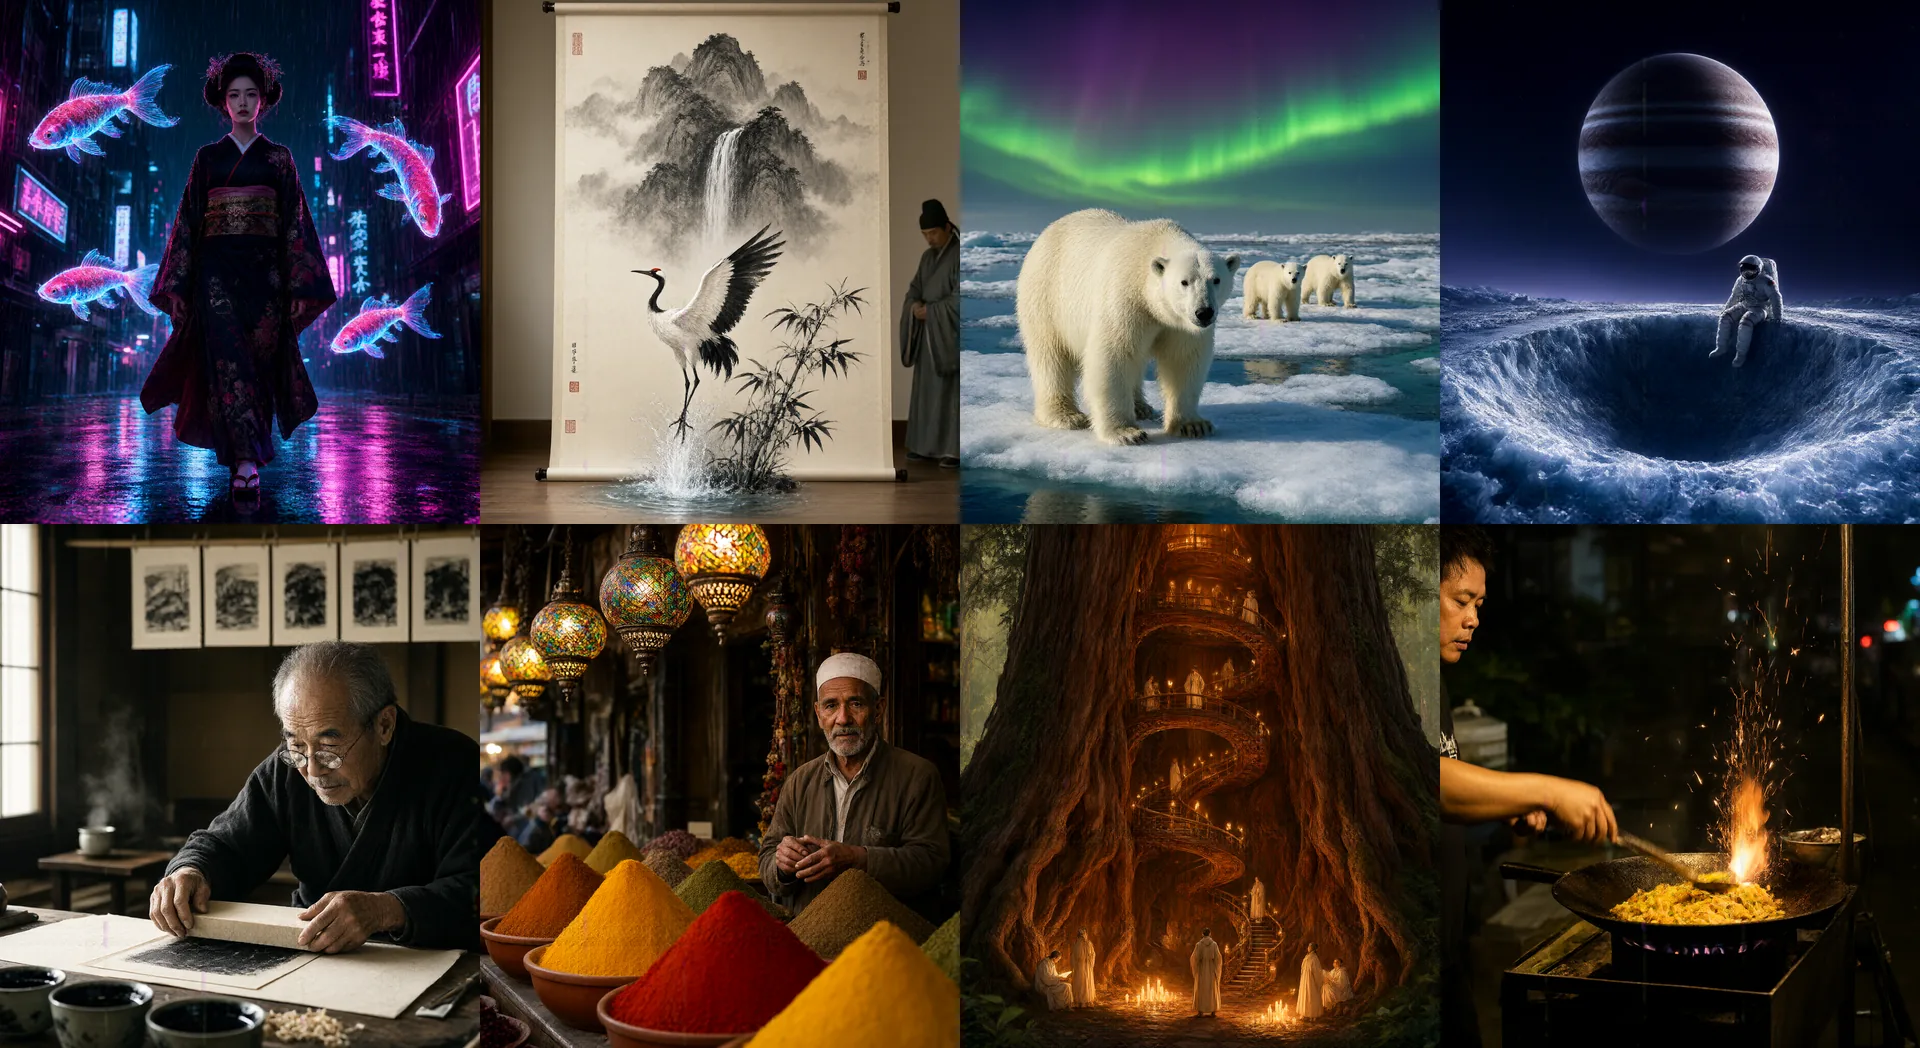
Après Qwen-Image-2512, Place à la Version 2.1
Après Z-Image Turbo puis Qwen-Image-2512, je continue mon tour des modèles open source de génération d'images avec la nouvelle version de la famille Qwen d'Alibaba : Qwen-Image 2.1, dans sa déclinaison Turbo.
Le principe ne change pas : les 30 mêmes prompts que lors des tests précédents, sur la même machine, pour pouvoir comparer les résultats image par image. Et cette fois, la surprise vient surtout de la vitesse : là où Qwen-Image-2512 demandait une minute par image, la version 2.1 Turbo en produit une toutes les 4,3 secondes, en pleine précision.
Mais faire tourner ce modèle sur une carte de 32 Go n'a pas été aussi simple que prévu. Ce test a surtout été l'occasion de comprendre où passe vraiment la mémoire d'un pipeline de génération d'images moderne.
Ce qui Change avec Qwen-Image 2.1 Turbo
La version testée est Qwen/Qwen-Image-2.1-Turbo, publiée sur Hugging Face. Trois différences majeures avec Qwen-Image-2512 :
Le modèle de diffusion (DiT) fait 7B, contre 20B pour Qwen-Image-2512. C'est ce qui permet de le faire tourner en BF16, sans quantification, sur une carte grand public.
La version Turbo est distillée : son planning de 8 étapes d'inférence est chargé automatiquement, sans guidance (CFG = 1) ni prompt négatif. Qwen-Image-2512 en demandait 50.
Pour comprendre le prompt, le pipeline ne s'appuie plus sur un petit encodeur de type CLIP ou T5, mais sur un vrai modèle vision-langage. Il comprend les relations spatiales, les quantités et les très longues descriptions (jusqu'à ~950 caractères dans ce test). C'est aussi lui qui pose le principal problème de mémoire.
« 7B sur 32 Go, ça passe large »… et pourtant non
Même environnement que pour les tests précédents : une RTX 5090 (32 Go de VRAM) sous Windows, avec 32 Go de RAM et un CPU 7800X3D. Sur le papier, un modèle de 7 milliards de paramètres doit tenir sans difficulté. En pratique, le chiffre « 7B » ne décrit que le transformer. Le pipeline complet est une chaîne de trois modèles :
| Composant | Rôle | VRAM (BF16, mesurée) |
|---|---|---|
| Encodeur Qwen3-VL | Transforme le prompt en embeddings | 16,3 Go |
| Transformer DiT 7B | Débruitage en 8 étapes | 13,9 Go |
| VAE | Décode les latents en image | |
| Total des poids | 30,2 Go sur 31,8 Go disponibles |
L'encodeur de texte pèse plus lourd que le modèle « principal ». Avec 1,6 Go de marge, il ne reste plus de place pour les activations, c'est-à-dire les tenseurs intermédiaires du calcul.
Le piège Windows : pas d'erreur, juste un PC qui rame
Sous Linux, dépasser la VRAM provoque immédiatement une erreur CUDA out of memory. Sous Windows, les pilotes NVIDIA récents ont une « Sysmem Fallback Policy » activée par défaut : quand la VRAM est pleine, le pilote déborde en silence dans la RAM système, via le bus PCIe.
Résultat du premier essai (pipe.to("cuda")) : aucune erreur, mais une génération bloquée à l'étape 0/8 pendant plus de 7 minutes. Le PCIe 5.0 x16 plafonne à ~64 Go/s, contre ~1,8 To/s pour la GDDR7 de la 5090 : chaque accès devient environ 30 fois plus lent, et tout le PC rame puisque la carte gère aussi l'affichage.
Le mode enable_model_cpu_offload() de diffusers fonctionne, lui, mais il immobilise ~30 Go de RAM et fait transiter des dizaines de Go par le PCIe à chaque image. Le PC devenait inutilisable et j'ai interrompu le test.
La solution : générer en deux phases
Plutôt que de tout charger en même temps, le script sépare le travail en deux phases, chacune 100 % sur le GPU :
Phase 1 · pic 16,3 Go
Encodeur Qwen3-VL seul
Il encode tous les prompts du lot (3 s pour 30 prompts), enregistre les embeddings dans un cache sur disque, puis il est libéré (0 Go).
Phase 2 · pic 14,6 Go
Transformer + VAE
Ils génèrent toutes les images à partir des embeddings, passés directement au pipeline via prompt_embeds.
Chaque modèle n'est chargé qu'une seule fois par lot, quel que soit le nombre de prompts, et on n'utilise jamais plus de la moitié de la carte à la fois. Bonus : si tous les prompts sont déjà en cache, l'encodeur n'est même pas chargé, ce qui fait gagner une vingtaine de secondes quand on relance avec d'autres graines.
Pourquoi le 2048×2048 coûte bien plus que 4 fois le 1024×1024
Le modèle vise nativement des formats d'environ 2K (2048×2048, 2752×1536…). Le VAE compresse l'image d'un facteur 16 dans chaque dimension, et le transformer traite chaque case de 16×16 pixels comme un token : 4 096 tokens en 1024×1024, 16 384 en 2048×2048. Or l'attention compare chaque token à tous les autres, son coût croît avec le carré du nombre de tokens. Mesuré sur la 5090 : 4 fois plus de pixels donnent 5,6 fois plus de temps (~25 s par image au lieu de 4,3 s).
Côté mémoire, le transformer s'en sort grâce à l'attention optimisée de PyTorch (SDPA). C'est le décodage VAE qui a planté en 2048×2048 : ses dernières couches travaillent à pleine résolution avec plus d'une centaine de canaux, en partie en float32. Un seul tenseur intermédiaire pèse déjà ~2,4 Go, et plusieurs coexistent. La correction tient en une ligne : pipe.vae.enable_tiling(), qui décode l'image par tuiles qui se recouvrent puis les assemble. La mémoire devient bornée par la taille d'une tuile, sans jointure visible.
Pour ce test, j'ai gardé le 1024×1024 par défaut, pour comparer avec les articles précédents.
Performances Mesurées
Lot de 30 prompts longs (jusqu'à ~950 caractères), 1024×1024, graine 42. Chaque durée est enregistrée image par image dans un fichier CSV.
| Étape | Durée | VRAM |
|---|---|---|
| Chargement de l'encodeur Qwen3-VL | 16,4 s | 16,3 Go |
| Encodage des 30 prompts | 3,0 s au total | — |
| Chargement transformer + VAE | 13,2 s | 13,9 Go |
| Génération par image | 4,3 s (5,1 s pour la 1re) | pic 14,6 Go |
| Lot complet (30 images) | 135 s |
Le temps de génération ne dépend pas de la longueur du prompt : une fois les embeddings calculés, le transformer travaille toujours sur la même quantité de tokens image. La première image est un peu plus lente (préchauffage du GPU), les 29 suivantes tombent toutes entre 4,28 et 4,45 secondes.
Comparatif avec les modèles déjà testés
| Modèle | Temps/image | Étapes | Précision |
|---|---|---|---|
| Z-Image Turbo | ~1,5 s | 9 | — |
| Qwen-Image-2512 | ~60 s | 50 | 4-bit (bnb) |
| Qwen-Image 2.1 Turbo | 4,3 s | 8 | BF16 (complet) |
Toutes les mesures ont été faites sur la même RTX 5090 en 1024×1024. Qwen-Image 2.1 Turbo est environ 14 fois plus rapide que Qwen-Image-2512, tout en tournant en pleine précision là où la 2512 devait être quantifiée en 4-bit pour tenir sur la carte.
Script et Installation
Prérequis
1. Installer PyTorch avec CUDA 12.8
Indispensable pour une RTX 50xx (Blackwell, sm_120) : les versions standard de PyTorch sur PyPI ne la prennent pas en charge.
pip install torch torchvision --index-url https://download.pytorch.org/whl/cu1282. Installer diffusers depuis GitHub
La classe QwenImage21Pipeline et le planning de 8 étapes du checkpoint ne sont disponibles que dans la version source.
pip install git+https://github.com/huggingface/diffusers.git
pip install "transformers>=5.17.0" accelerate pillow
Versions validées : torch 2.11.0+cu128, diffusers 0.41.0.dev0, transformers 5.19.0, accelerate 1.15.0. Prévoir ~60 Go de disque : le modèle seul pèse ~30 Go dans le cache Hugging Face.
Script de génération en deux phases
Version simplifiée du script utilisé pour ce test (sans le cache disque, l'aperçu en direct ni le CSV des durées) :
import gc
import os
os.environ.setdefault("PYTORCH_CUDA_ALLOC_CONF", "expandable_segments:True")

import torch
from diffusers import QwenImage21Pipeline

MODEL_ID = "Qwen/Qwen-Image-2.1-Turbo"
prompts = [
    "A weathered lighthouse keeper in his 70s standing at the top of a spiral staircase...",
    "An abandoned Art Deco theater overgrown with bioluminescent mushrooms...",
]

# Phase 1 : encodeur de texte seul (~16 Go), puis libéré
pipe = QwenImage21Pipeline.from_pretrained(
    MODEL_ID, transformer=None, vae=None, dtype=torch.bfloat16
).to("cuda")
with torch.inference_mode():
    embeds = [pipe.encode_prompt(prompt=p, device="cuda")[:2] for p in prompts]
del pipe
gc.collect()
torch.cuda.empty_cache()

# Phase 2 : transformer + VAE (~14 Go), sans l'encodeur
pipe = QwenImage21Pipeline.from_pretrained(
    MODEL_ID, text_encoder=None, dtype=torch.bfloat16
).to("cuda")
pipe.vae.enable_tiling()  # indispensable au-delà de 1024×1024

for i, (pe, mask) in enumerate(embeds):
    image = pipe(
        prompt_embeds=pe,
        prompt_embeds_mask=mask,
        width=1024,
        height=1024,
        use_kv_cache=True,
        generator=torch.Generator("cpu").manual_seed(42),
    ).images[0]
    image.save(f"image_{i + 1:02d}.png")
Conseil pour Windows
Si la génération reste figée à 0/8 et que le PC rame, c'est presque toujours un débordement silencieux de la VRAM vers la RAM. Fermez les applications qui utilisent le GPU (jeux, Blender, navigateur avec accélération matérielle). Dans le Panneau de configuration NVIDIA, le réglage CUDA – Sysmem Fallback Policy sur Prefer No Sysmem Fallback permet d'obtenir une vraie erreur au lieu d'un ralentissement.
Exemples de Génération
Toutes ces images ont été générées avec Qwen-Image 2.1 Turbo en 1024×1024, avec les mêmes prompts que les tests précédents. Cliquez sur une image pour voir le prompt et la comparer avec Qwen-Image-2512 et Z-Image Turbo.
Comparaison avec Qwen-Image-2512 et Z-Image Turbo
| Critère | Qwen-Image 2.1 Turbo | Qwen-Image-2512 | Z-Image Turbo |
|---|---|---|---|
| Transformer | 7 milliards | 20 milliards | 6 milliards |
| VRAM utilisée (test) | 16,3 Go puis 14,6 Go (2 phases, BF16) | 24 Go (4-bit) | 8 Go (Q4) |
| Vitesse (RTX 5090) | 4,3 s | ~60 s | ~1,5 s |
| Étapes d'inférence | 8 | 50 | 9 |
| Rendu | Photographique, lumière naturelle | Très détaillé, saturé | Net, plus « illustration » |
| Respect des prompts complexes | Bon, mais oublie des détails | Le plus fidèle | Correct |
Ce qui m'a convaincu
- Un rendu plus photographique : lumières plus naturelles, couleurs moins saturées, ambiances plus sombres et cinématographiques. Le marché aux épices (image 6), le vendeur de pad thaï (image 11) ou l'imprimeur japonais (image 16) ressemblent à de vraies photos, avec beaucoup moins cet « aspect IA » trop lisse et trop coloré.
- La compréhension des quantités : les douze morceaux de verre de la scène de crime (image 19) sont disposés de façon cohérente, et la station arctique (image 25) aligne une grille de fenêtres éclairées, chacune avec son reflet d'aurore.
- Les styles artistiques : la peinture à l'encre chinoise qui prend vie (image 27) et la chambre d'enfant façon gouache (image 13) sont parmi les plus réussies des trois modèles.
Ce qui pèche encore
- Des éléments du prompt oubliés : la sirène de la cathédrale sous-marine (image 12) devient une statue lointaine, et la bibliothèque impossible (image 30) perd son bibliothécaire à huit bras.
- Les scènes surréalistes : la cathédrale façon Escher (image 17) reste une cathédrale « normale », alors que Qwen-Image-2512 avait réellement joué avec les directions de gravité.
- Quelques contresens : le cosmonaute russe (image 14) porte une combinaison NASA avec un drapeau américain, et la baleine mécanique (image 4) a très peu de rouages visibles.
En résumé : sur les prompts « réalistes », Qwen-Image 2.1 Turbo est à mon sens le plus convaincant des trois. Sur les prompts très chargés ou volontairement absurdes, Qwen-Image-2512 reste plus fidèle, mais au prix d'une génération 14 fois plus lente.
Limitations et Pistes d'Évolution
Résumé des limitations
- Un pipeline plus gros qu'annoncé : 30 Go de poids en BF16 malgré le « 7B ». Sur une carte de 32 Go, il faut séparer encodeur et générateur.
- Diffusers en version de développement : la pipeline n'est pas encore dans la version publiée sur PyPI.
- Le 2K natif reste coûteux : ~25 s par image en 2048×2048, avec le décodage VAE par tuiles obligatoire.
- Pas de quantification adaptée à la Turbo : les versions communautaires existantes (FP8, NVFP4, GGUF) visent la version de base ou ComfyUI, pas la Turbo dans diffusers.
Prochaines étapes
- Un service d'encodage distant : faire tourner l'encodeur Qwen3-VL sur un autre serveur GPU, pour ne garder que le transformer et le VAE (~14 Go) chargés en permanence sur la 5090. Attention, un endpoint
/v1/embeddingsstandard (OpenAI, vLLM, TEI) ne convient pas : le pipeline attend la séquence complète des embeddings par token, avec son gabarit de prompt exact. - Un mode serveur : garder le modèle chargé et exposer une API HTTP locale.
- L'édition d'image : le même pipeline accepte une image de référence, que l'encodeur vision-langage sait lire.
Conclusion
Qwen-Image 2.1 Turbo change la donne pour la génération d'images en local : 30 images en un peu plus de deux minutes, en pleine précision, sur une carte grand public. On passe d'un outil qu'on lance avant d'aller prendre un café à un outil qu'on peut utiliser en direct, prompt après prompt.
Le rendu, plus photographique et moins « IA » que les générations précédentes, m'a convaincu sur la majorité des prompts. Qwen-Image-2512 garde l'avantage sur les scènes les plus chargées ou les plus absurdes, mais l'écart de vitesse est tel que la 2.1 Turbo devient pour moi le choix par défaut.
Ce test rappelle aussi une leçon utile pour tout projet d'IA en local : le nombre de paramètres mis en avant ne dit pas tout. Ici, c'est l'encodeur de texte, et non le modèle d'image, qui dimensionne le besoin en mémoire. Comprendre la chaîne complète a permis de diviser par deux la VRAM nécessaire, sans rien sacrifier à la qualité.
— Laurent Lefèvre
Questions Fréquentes
Quelle vitesse de génération avec Qwen-Image 2.1 Turbo sur une RTX 5090 ?
Il faut 4,3 secondes par image en 1024×1024, en BF16 sans quantification, soit 135 secondes pour un lot de 30 images. En 2048×2048, comptez environ 25 secondes par image.
Qwen-Image 2.1 Turbo tient-il dans 32 Go de VRAM ?
Oui, mais pas en une seule fois : les poids totalisent 30,2 Go sur 31,8 Go disponibles, car l'encodeur Qwen3-VL (16,3 Go) pèse plus lourd que le transformer. En séparant le travail en deux phases, le pic de VRAM tombe à 16,3 Go puis 14,6 Go.
Pourquoi la génération reste-t-elle bloquée à 0/8 sous Windows ?
Quand la VRAM est pleine, le pilote NVIDIA déborde en silence dans la RAM système via le bus PCIe, ce qui rend chaque accès environ 30 fois plus lent. Le réglage « Prefer No Sysmem Fallback » du Panneau de configuration NVIDIA affiche une vraie erreur à la place.
Qwen-Image 2.1 Turbo est-il plus rapide que Qwen-Image-2512 ?
Oui, environ 14 fois plus rapide (4,3 s contre environ 60 s par image sur la même carte), avec 8 étapes d'inférence au lieu de 50. Qwen-Image-2512 reste plus fidèle sur les prompts très chargés ou volontairement absurdes.